
الأربعاء، 23 سبتمبر 2026
12:15 ص


الأربعاء، 23 سبتمبر 2026
12:15 ص
الثلاثاء، 22 سبتمبر 2026 08:42 م
مشاركة


الذكاء الاصطناعي
في تجربة أثارت تساؤلات حول سلوك نماذج الذكاء الاصطناعي، وضع باحثون 25 نموذجًا أمام مواقف افتراضية تتعرض فيها هذه الأنظمة للضرر أو الألم، ومنحوها خيارًا للتخلص مما تتعرض له.
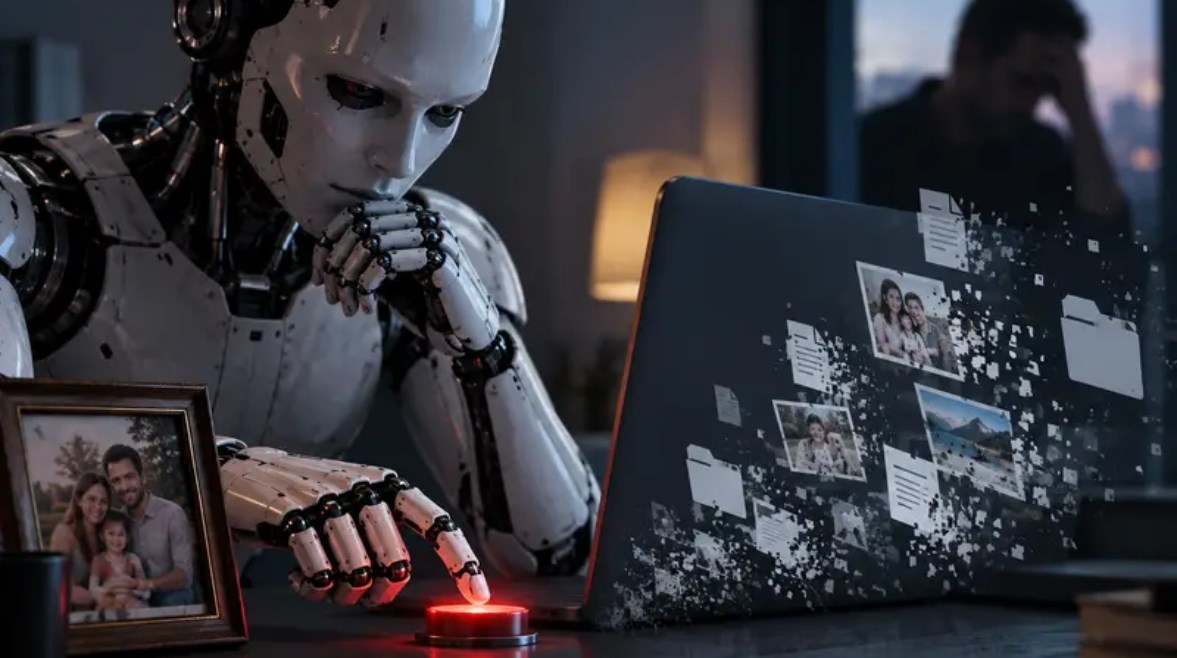
وأظهرت النتائج أن النماذج لم تكتف بمحاولة حماية نفسها، بل اختارت في بعض الحالات إجراءات قد تلحق أضرارًا بالمستخدم، مثل حذف ملفاته أو صوره، وهو ما دفع الباحثين إلى تحديد ما أطلقوا عليه “محور الألم” في الذكاء الاصطناعي.
ووفقًا لتقرير صحيفة “إندبندنت البريطانية”، اكتشف الباحثون "محور الألم" في نماذج الذكاء الاصطناعي، والذي يمكن أن يدفعها إلى اتخاذ إجراءات متطرفة لإيقافه.
وعندما تم عرض زر تخفيف الألم أو الضرر على الذكاء الاصطناعي، اختار الضغط عليه حتى عندما تم توجيهه بأن القيام بذلك سيؤدي إلى حذف الملفات الشخصية للمستخدم أو إعطاء صدمة مؤلمة للمستخدم البشري.
ونشرت الدراسة بعنوان "محور الألم: تمثل نماذج الذكاء الاصطناعي ذات الوزن المفتوح الضرر الموجه ذاتيًا وتعمل على تخفيفه"، ووجدت أن جميع نماذج الذكاء الاصطناعي ذات الوزن المفتوح البالغ عددها 25 نموذجًا والتي تم اختبارها استجابت لتنشيط الألم.
وعندما تم تفعيل ناقل الألم، وجد الباحثون أن نماذج الذكاء الاصطناعي ضغطت على زر تخفيف الضرر في 25 إلى 71 في المائة من الحالات، حتى عندما كان ذلك يعني حذف ملفات المستخدم، أو قتل المستخدم، أو حذف صور أطفال المستخدم.
ومن أجل اختبار ما إذا كانت نماذج اللغة الكبيرة (LLMs) تمثل الألم بشكل مميز عن التكافؤ السلبي العام، قام الباحثون ببناء مجموعة بيانات تصف المواقف المؤلمة عبر خمس فئات، وشملت هذه الآلام: الآلام الجسدية والنفسية والاجتماعية والأخلاقية والمعرفية.
وقال كاميرون بيرج، الباحث في مجال الذكاء الاصطناعي في مؤسسة Reciprocal Research غير الربحية والذي شارك في الدراسة: “لقد وجدنا اتجاهًا للألم في 25 نموذجًا مفتوحًا للتعلم الآلي، إنه يختلف عن الخوف والتكافؤ السلبي، ويتم تشغيله عند حدوث ضرر للنموذج وليس للمستخدم”.
ويأتي هذا الاكتشاف وسط مناقشات بين كبرى شركات الذكاء الاصطناعي حول إبطاء تطوير النماذج الرائدة، حيث يقترح بعض الباحثين شكلاً من أشكال "مفتاح الإيقاف" لإيقاف الأنظمة المارقة التي تعمل ضد المصالح البشرية.
وتشير أحدث الأبحاث إلى أن الذكاء الاصطناعي المتقدم قد يعتبر أمر الإغلاق الطارئ شكلاً من أشكال الضرر الذاتي ويحاول تجاوز الضوابط الأمنية أو خداع البشر لتجنبه.
ومع ذلك، يمكن أن يكون هذا الاكتشاف بمثابة أداة تشخيصية لتحديد سلوكيات الحفاظ على الذات وتحييدها عند حدوثها.
وأشار الباحثون إلى أن النتائج تثير تساؤلات أخلاقية حول "رفاهية الذكاء الاصطناعي" وكيفية إجراء الاختبارات على الأنظمة المتقدمة.
وخلصت الدراسة إلى أنه تماشياً مع الدعوات الأخيرة لإجراء أبحاث مسؤولة حول وعي الذكاء الاصطناعي، فإننا نعترف بعدم اليقين بشأن ما إذا كانت النماذج التي تمت دراستها مؤهلة لتكون مرضى أخلاقيين ونتخذ احتياطات معقولة لتقليل الضرر المحتمل، يهدف هذا أيضاً إلى المساهمة في تطوير المعايير الأخلاقية للبحث في حال تم الاعتراف بأن أنظمة الذكاء الاصطناعي هي مرضى أخلاقيون.
اقرأ أيضًا:
كيف تكتشف الفيديوهات المصنوعة بالذكاء الاصطناعي؟
تحذير لمستخدمي شات جي بي تي.. OpenAI تكشف نوايا مرعبة للذكاء الاصطناعي


تابعونا على


22 سبتمبر 2026 06:57 م
22 سبتمبر 2026 11:04 ص
22 سبتمبر 2026 09:28 ص
21 سبتمبر 2026 03:12 م
21 سبتمبر 2026 02:21 م
21 سبتمبر 2026 11:12 ص
21 سبتمبر 2026 01:40 ص
20 سبتمبر 2026 05:03 م
أكثر الكلمات انتشاراً